
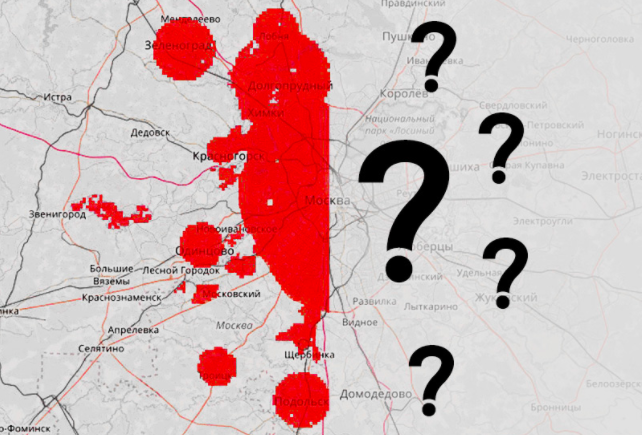
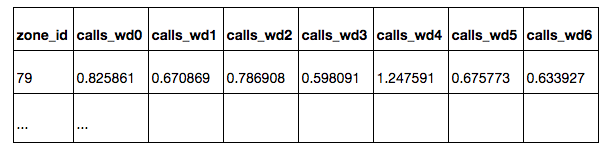
В таблице zones.csv перечислены все квадраты с указанием их координат. Все квадраты расположены в Москве, либо на небольшом расстоянии от Москвы. Квадраты, расположенные в западной части выборки, предназначены для обучения модели — для этих квадратов известно среднее число вызовов экстренных служб из квадрата в день:
calls_daily: по всем дням
calls_workday: по рабочим дням
calls_weekend: по выходным дням
calls_wd{D}: по дню недели D (0 — понедельник, 6 — воскресенье)
На квадратах из восточной части выборки необходимо построить прогноз числа вызовов по всем дням недели. Оценка качества предсказания будет производиться по подмножеству квадратов, в которое не входят квадраты, откуда вызовы поступают крайне редко. Подмножество целевых квадратов имеет is_target=1 в таблице. Для тестовых квадратов значения calls_* и is_target скрыты.
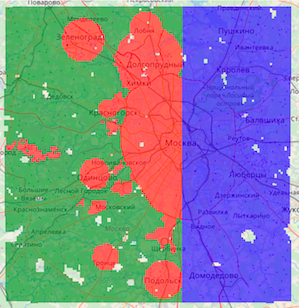
На карте обозначены квадраты трех типов:
Зеленые — из обучающей части, не целевые
Красные — из обучающей части, целевые
Синие — тестовые, на них необходимо построить прогноз
В качестве решения необходимо предоставить CSV таблицу с предсказаниями для всех тестовых квадратов, для каждого квадрата — по всем дням недели.
Качество оценивается только по подмножеству целевых квадратов. Участникам неизвестно, какие из квадратов целевые, однако принцип выбора целевых квадратов в обучающей и тестовой части — идентичен. Во время соревнования качество оценивается на 30% тестовых целевых квадратов (выбраны случайно), в конце соревнования итоги подводятся по оставшимся 70% квадратов.
Метрика качества предсказаний — коэффициент ранговой корреляции Kendall’s Tau-b, считается как доля пар объектов с неправильно упорядоченными предсказаниями с поправкой на пары с одинаковым значением целевой переменной. Метрика оценивает порядок, в котором предсказания соотносятся друг с другом, а не их точные значения. Разные дни недели считаются независимыми элементами выборки, т.е. коэффициент корреляции считается по предсказаниям для всех тестовых пар (zone_id, день недели).

Извлечение признаков из OpenStreetMap
Предсказание числа вызовов можно осуществить методами машинного обучения. Для этого каждому квадрату необходимо построить вектор с признаковым описанием. Обучив модель на размеченной западной части Москвы, ее можно будет использовать для предсказания целевой переменной в восточной части.
По условиям соревнования, данные для решения задачи можно брать из любых открытых источников. Когда речь идет об описании небольшой области на карте, первое что приходит в голову — OpenStreetMap, открытая некоммерческая электронная карта, которая создается руками сообщества.
Карта OSM представляет собой набор элементов трех видов:
Node: точки на карте
Way: дороги, площади, задаются набором точек
Relation: связи между элементами, например объединение дороги из нескольких частей
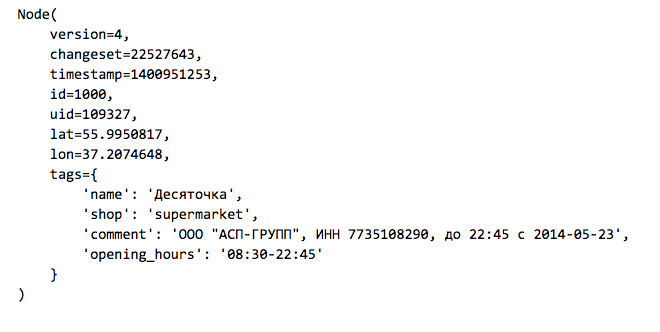
Элементы могут иметь набор тегов — пар ключ-значение. Вот пример магазина, который указан на карте как элемент типа Node:
Актуальную выгрузку данных OpenStreetMap можно взять с сайта GIS-Lab.info. Так как нас интересует Москва и ее ближайшее окружение, загрузим файл RU-MOS.osm.pbf — часть OpenStreetMap из соответствующего региона в бинарном формате osm.pbf. Для чтения таких файлов из Python имеется простая библиотека osmread.
Прежде чем начать работать, считаем из OSM все элементы типа Node из нужной нам области, которые имеют теги (остальные отсеим и не будем использовать в дальнейшем).

Работая в Python, геоданные можно быстро визуализировать на интерактивной карте при помощи библиотеки folium, у которой под капотом Leaflet.js — стандартное решение для отображения OpenStreetMap.

Агрегируем полученный набор точек по квадратам и построим простые признаки:
1. Расстояние от центра квадрата до Кремля
2. Число точек в радиусе R от центра квадрата (для различных значений R)
a. всех точек с тегами
b. ж/д станций
c. магазинов
d. остановок общественного транспорта
3. Максимальное и среднее расстояние от центра квадрата до ближайших точек перечисленных выше видов
Для быстрого поиска точек, находящихся в близости с центром квадрата, будем использовать структуру данных k-d tree, реализованную в пакете SciKit-Learn в классе NearestNeighbors.


В итоге для каждого квадрата из обучающей и тестовой выборки имеем признаковое описание, которое можно использовать для предсказания. Небольшой модификацией предложенного кода можно учесть в признаках объекты других типов. Участники могут добавлять свои признаки, тем самым давая модели больше информации о городской застройке.
Предсказание числа вызовов
Опытные участники соревнований по анализу данных знают, что для получения высокого места важно не только смотреть на публичный лидерборд, но и делать собственную валидацию на тренировочной выборке. Сделаем простое разбиение тренировочной части выборки на подвыборки для обучения и валидации в соотношении 70/30.
Возьмем только целевые квадраты и обучим модель случайного леса (RandomForestRegressor) предсказывать среднее число вызовов в день.

Оценим качество на валидационной подвыборке, для всех дней недели построим одинаковый прогноз. Метрика качества — непараметрический коэффициент корреляции Кендалла tau-b, он реализован в пакете SciPy в виде функции scipy.stats.kendalltau.
Получается Validation score: 0.656881482683
Это неплохо, т.к. значение метрики 0 означает отсутствие корреляции, а 1 — полное монотонное соответствие реальных значений и предсказанных.

До вхождения в ряды участников, которые получат приглашение на Data Fest, остается один небольшой шаг: построить таблицу с предсказаниями на всех тестовых квадратах и отправить их в систему.

Зачем анализировать геоданные?
Основными источниками данных, не только пространственных (географических), но и временных, для любой телеком-компании являются расположенные на всей территории стран обслуживания комплексы аппаратуры для приема и передачи сигнала — Базовые Станции (БС). Пространственный анализ данных труднее технически, но может принести существенную пользу и получить признаки, добавляющие весомый вклад в эффективность моделей машинного обучения.
В компании МТС использование географических данных помогает расширить базу знаний. Они могут использоваться для повышения качества предоставляемого сервиса при анализе жалоб абонентов на качество связи, улучшения зоны покрытия сигнала связи, планирования развития сети и решения других задач, где пространственно временная связь является важным фактором.
Возрастающая, особенно в крупных городах, плотность населения, стремительное развитие объектов инфраструктуры и дорожной сети, космические снимки и векторные карты, количество строений и POI (points of interest) с открытых карт местности, связанных с оказание сервисных услуг – все эти пространственные данные можно получить из внешних источников. Такие данные могут применяться как дополнительный источник информации, а также позволят получить объективную картину вне зависимости от покрытия сети.
Понравилась задача? Тогда мы приглашаем вас принять участие в онлайн-хакатоне по анализу географических данных Geohack.112. Регистрируйтесь и загружайте свои решения на сайт до 24 апреля. Авторы трех лучших результатов получат денежные призы. Отдельные номинации предусмотрены для участников, представивших лучшее публичное решение задачи и лучшую визуализацию журналистики данных. Общий призовой фонд МТС GeoHack — 500 000 рублей. Мы надеемся увидеть новые интересные подходы к генерации пространственных фичей, визуализации геоданных и использования новых открытых источников информации.
Награждение победителей пройдет 28 апреля на конференции DataFest.