
В конечном итоге, как мне показалось, нет лучше способа разобраться, чем просто взять и создать свой маленький проект.
Можно прочитать лирическую предысторию, разворачивая текст, а можно это пропустить и перейти непосредственно к описанию нейросети.
- Лучше понимаешь, как устроены нейронки
- Лучше понимаешь, как работать с уже с существующими библиотеками
- Параллельно изучаешь что-то новое
- Щекочешь своё Эго, создавая что-то своё
Минусы:
- Создаёшь велосипед, притом скорее всего хуже существующих
- Всем плевать на твой проект
Описание сети.
Характеристики:
| Название | FoxNN (Fox-Neural-Network) |
| Операционная система | Windows, Linux |
| Языки | C++, Python |
| Ускорение | CPU (GPU в планах) |
| Внешние зависимости | Нет (чистый С++, STL, OpenMP) |
| Флаги компиляции | -std=c++14 -fopenmp |
| Слои | линейные (сверточные в планах) |
| Оптимизации | Адам, Нестеров |
| Случайное изменение весов | Есть |
| Википедия (инструкция) | Есть |
Основным преимуществом моей библиотеки является создание сети одной строчкой кода.
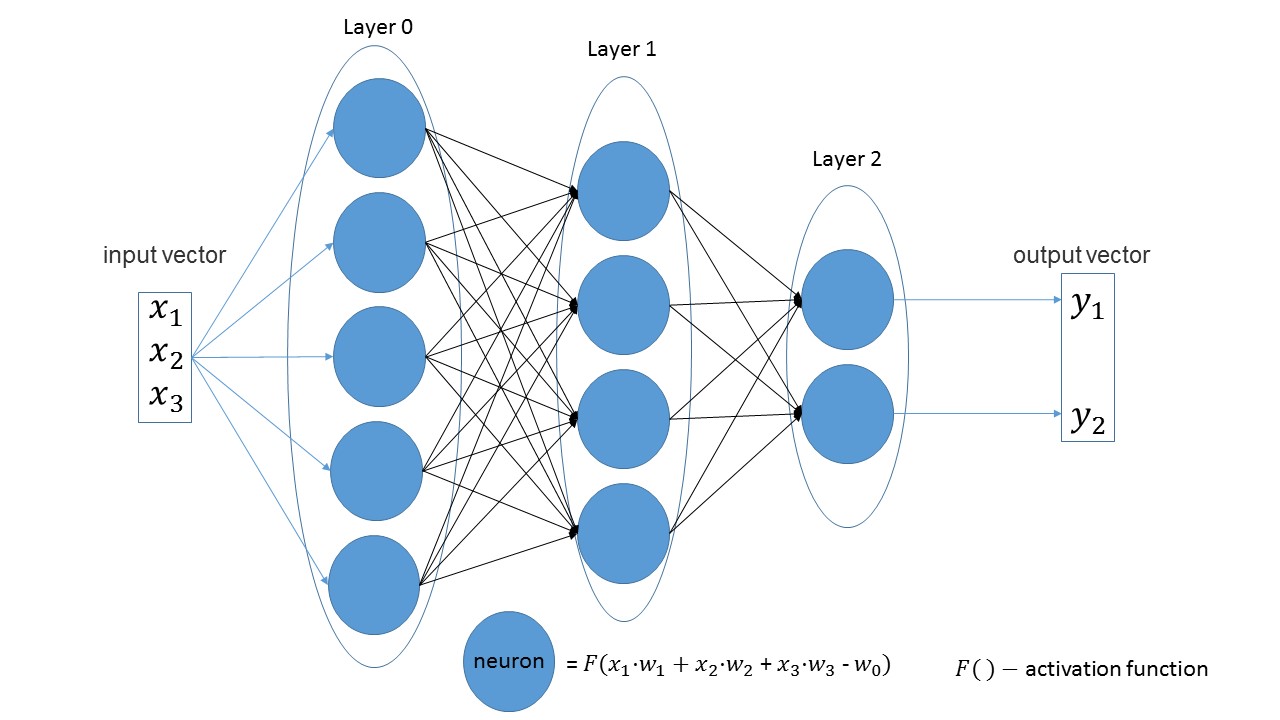
Легко заметить, что в линейных слоях количество нейронов в одном слое равняется количеству входных параметров в следующем слое. Ещё одно очевидное утверждение — число нейронов в последнем слое равняется количеству выходных значений сети.
Давайте создадим сеть, получающую на вход три параметра, имеющую три слоя с 5-ью, 4-мя и 2-мя нейронами.
import foxnn
nn = foxnn.neural_network([3, 5, 4, 2])
Если взглянуть на рисунок, то можно как раз увидеть: сначала 3 входных параметра, затем слой с 5-ью нейронами, затем слой с 4-мя нейронами и, наконец, последний слой с 2-мя нейронами.
По умолчанию все функции активации являются сигмоидами (мне они больше нравятся).
При желании, на любом слое можно поменять на другую функцию.
nn.get_layer(0).set_activation_function("gaussian")
Легко создать обучающую выборку. Первый вектор — входные данные, второй вектор — целевые данные.
data = foxnn.train_data()
data.add_data([1, 2, 3], [1, 0]) #на вход три параметра, на выход два параметра
Обучение сети:
nn.train(data_for_train=data, speed=0.01, max_iteration=100, size_train_batch=98)
Включение оптимизации:
nn.settings.set_mode("Adam")
И метод, чтобы просто получить значение сети:
nn.get_out([0, 1, 0.1])
Тестирование.
Уже вошло в негласную традицию тестировать любую сеть на базе MNIST. И я не стал исключением. Весь код с комментариями можно посмотреть тут.
from mnist import MNIST
import foxnn
mndata = MNIST('C:download/')
mndata.gz = True
imagesTrain, labelsTrain = mndata.load_training()
def get_data(images, labels):
    train_data = foxnn.train_data()
    for im, lb in zip(images, labels):
        data_y = [0, 0, 0, 0, 0, 0, 0, 0, 0, 0] # len(data_y) == 10
        data_y[lb] = 1
        data_x = im
        for j in range(len(data_x)):
            # приводим пиксель в диапазон (-1, 1)
            data_x[j] = ((float(data_x[j]) / 255.0) - 0.5) * 2.0
        train_data.add_data(data_x, data_y) # добавляем в обучающую выборку
    return train_data
train_data = get_data(imagesTrain, labelsTrain)
nn = foxnn.neural_network([784, 512, 512, 10])
nn.settings.n_threads = 7 # распараллеливаем процесс обучения на 7 процессов
nn.settings.set_mode("Adam") # используем оптимизацию Адама
nn.train(data_for_train=train_data, speed=0.001, max_iteration=10000, size_train_batch=98)
Что получилось:
Примерно за 10 минут (только CPU ускорение), можно получить точность 75%. С оптимизацией Адама за 5 минут можно получить точность 88% процентов. В конечном итоге мне удалось достичь точности в 97%.
2) Пока обучение указывается в итерациях, а не в эпохах, как это принято в других сетях.
3) Нет GPU ускорения
4) Пока нет других видов слоёв.
5) Надо залить проект на PyPi.
Для маленькой завершённости проекта не хватало как раз этой статьи. Если хотя бы десять человек заинтересуются и поиграются, то уже будет победа. Добро пожаловать на мой GitHub.
P.s. Если вам для того, чтобы разобраться, нужно создать что-то своё, не бойтесь и творите.