
- Обработка изображений,
- Машинное обучение,
- Разработка на Raspberry Pi,
- Робототехника,
- Искусственный интеллект
Слабым местом было распознавание самого дорожного полотна из-за переменчивости цветовых оттенков, из-за чего нейросеть, принимающая решения, выдавала странные результаты. В комментариях к той статье рекомендовали обратить внимание на семантическую сегментацию. Тема оказалась перспективной и применение сегментирующей нейросети принесло свои плюсы, но и минусы, куда же без них.
Но обо всем по порядку и для начала немного матчасти.
Сегментация
Сегментация — процесс выделения некоторых частей на изображении. Простейший и самый очевидный вид сегментации — по цвету. Однако, используя этот метод, невозможно понять, что и где изображено на картинке.
Вот неплохая статья, описывающая примитивные подходы.
Семантическая сегментация
Семантическая сегментация — разбиение изображения на объекты с определением типов этих объектов.
Выглядит это как-то так:

Результаты очень впечатляющие, посмотрим чего стоит воплотить это в реальной жизни.
U-net
Самая известная нейросеть, изначально разработанная для медицины.
Первоисточник
Народ быстро сообразил, что подход можно использовать на все случаи жизни.
В интернете много статей, как готовить данные и обучать U-net сети:
Однако, готовой U-net сети, чтобы быстро взять и поэкспериментировать, я не нашел.
E-net
Более молодая и менее известная сеть. Разработана как раз для распознавания городских улиц.
Данные
Самые популярные датасеты, для сегментации улиц (на них изначально обучали E-net):
- CityScapes — Немецкие и швейцарские города
- CamVid — улицы Кембриджа в Англии
- SUN — Принстонский набор датасетов для разных видов сцен
На этих же датасетах сейчас обучают и U-net.
Выбор реализации
Поток новой информации по сегментации был довольно ошеломляющим. Инстинктивно хотелось зацепиться за что-нибудь попроще. Внутреннего дзена разбираться в архитектуре сетей и тратить время на обучение я в себе не почувствовал. Зато в статье от PyImageSearch была уже готовая и обученная нейросеть, причем в формате совместимом с OpenCV-DNN.
Так что выбор был сделан в сторону наименьшего сопротивления.
Использование очень простое:
(Более всего беспокоит то, что сеть обучена на картинках размером 1024×512 — это во-первых больше, чем отдает камера на Raspberry, во-вторых требуемая производительность для обработки такого объема данных несколько смущает. В итоге, главная проблема окажется именно в этом).
Читаем нейросеть из файлов (в одном сама модель, в другом имена классов, в третьем — цвета).
def load_segment_model():
    try:
        classes = None
        with open(PiConf.SEGMENT_CLASSES) as f:
            classes = f.read().strip().split("n")
        colors = None
        with open(PiConf.SEGMENT_COLORS) as f:
            colors= f.read().strip().split("n")
        colors = [np.array(c.split(",")).astype("int") for c in colors]
        colors = np.array(colors, dtype="uint8")
        print("[INFO] loading model...")
        net = cv2.dnn.readNet(PiConf.SEGMENT_MODEL)
        return net, classes, colors
    except Exception as e:
        logging.exception("Cannot load segment model")
    return None, None, None
Сегментируем изображение, попутно размечая сегменты поверх оригинального изображения
(В моем случае все классы, кроме дороги, невидимы).
def segment_image(image_path, seg_net, seg_classes, seg_colors):
    image0 = cv2.imread(image_path)
    image = cv2.resize(image0, (1024, 512),interpolation=cv2.INTER_NEAREST)
    blob = cv2.dnn.blobFromImage(image, 1 / 255.0, (1024, 512), 0, swapRB=True, crop=False)
    seg_net.setInput(blob)
    start = time.time()
    output = seg_net.forward()
    end = time.time()
    print("[INFO] inference took {:.4f} seconds".format(end - start))
    (numClasses, height, width) = output.shape[1:4]
    classMap = np.argmax(output[0], axis=0)
    mask = seg_colors[classMap]
    mask = cv2.resize(mask, (image0.shape[1], image0.shape[0]),interpolation=cv2.INTER_NEAREST)
    classMap = cv2.resize(classMap, (image0.shape[1], image0.shape[0]), interpolation=cv2.INTER_NEAREST)
    gmask = cv2.cvtColor(mask, cv2.COLOR_BGR2GRAY)
    gmask = cv2.resize(gmask, (128, 64), interpolation=cv2.INTER_NEAREST)
    gmask = gmask[0:64,32:96]
    output = ((0.6 * image0) + (0.4 * mask)).astype("uint8")
    return output, gmask
Проверка
Берем готовые картинки с танка и натравливаем на них сегментирующую нейросеть.
1

Дорогой признана только левая часть тротуара.
Сжимаем картинку и берем из нее центр размером 64×64:
(Такой размер ожидается нейросетью, которая принимает решение о смене направления)

Нейросеть направления (по факту — классификатор) командует взять влево.
Не очень правильно, но терпимо.
2

Похожая ситуация, опять правый нижний угол потерян (там еще и асфальт мокрый).
Однако большая часть дороги все же распознана.

Классификатор предлагает ехать прямо.
3
Ситуция, когда робот оказался посреди тротуара.
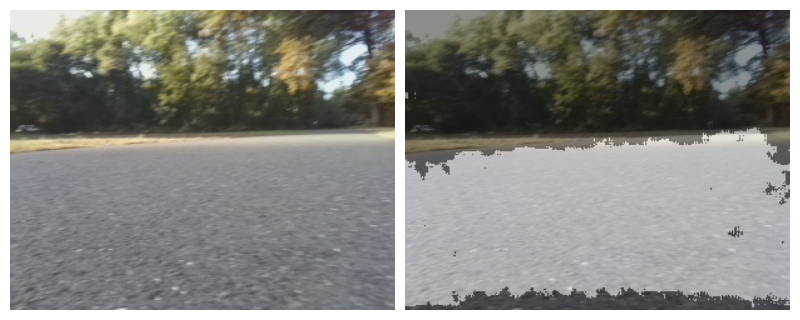
Дорога распознана практически идеально.

Классификатор командает брать вправо (чтобы найти кромку дороги в следующий раз).
Применение
Поколдовав немного над прошивкой танка, заменил цветовой детектор дороги на сегментирующую нейросеть.
При запуске всего этого на Raspberry Pi первое, что вылезло — удручающая производительность.
На сегментацию одного изображения уходит по 6 секунд — за это время танк бодрой рысцой успевает проскочить все повороты.
В реальных испытаниях так и получилось — несмотря на практически идеальное распознавание тротуара и правильные команды с управляющей нейросети — за время время обработки изображения танк успевал уйти в сторону.

В общем, на Raspberry картинки такого размера не переварить.
Похоже, все таки придется заняться обучением специализированной нейросети.